RAG на русском: как заставить LLM работать с вашими документами без галлюцинаций
Опубликовано 8 октября 2026 · обновлено 9 октября 2026 · Редакция Картомер
Вы загрузили в нейросеть внутренний регламент и спросили про отпуск, а она уверенно выдала правила, которых в документе нет. Знакомая ситуация? Языковая модель отвечает «по памяти» и склонна выдумывать детали, особенно когда речь о ваших закрытых данных.
Лекарство от этого — RAG на русском и на любом другом языке: сначала система находит нужные куски ваших документов, и только потом модель формулирует ответ. Ниже разберём, как это устроено, где подстерегают ошибки с русским текстом и как оплатить зарубежные API. Если пользуетесь платными моделями, способы оплаты собраны в разделе об оплате.
Вы узнаете:
- RAG что это и как работает цепочка «поиск → ответ»;
- чем осложняется работа с русским языком;
- из каких частей собирают систему для документов;
- какие бывают типы RAG и как оплатить API.
RAG что это простыми словами
RAG, или retrieval augmented generation («генерация, дополненная поиском»), — подход, при котором языковая модель не отвечает на вопрос сразу, а получает вместе с вопросом подборку подходящих фрагментов из вашей базы знаний. Модель опирается на найденный текст, поэтому ответ проще проверить, а выдумок становится меньше.
Это не отключает галлюцинации полностью. Если поиск принёс не те фрагменты, даже сильная модель сделает неверный вывод. Поэтому вся работа над качеством RAG — это работа над поиском.
Как работает RAG шаг за шагом
Система состоит из двух этапов: подготовки базы и ответа на запрос.
Подготовка:
- Документы очищают от мусора и разбивают на небольшие смысловые блоки (чанки).
- Каждый блок превращают в числовой вектор с помощью эмбеддинг-модели.
- Векторы и исходные тексты сохраняют в векторной базе.
Ответ:
- Вопрос пользователя тоже превращают в вектор.
- Система ищет ближайшие по смыслу блоки.
- Найденные фрагменты добавляют к запросу и отправляют в языковую модель.
- Модель пишет ответ, а система показывает источники.
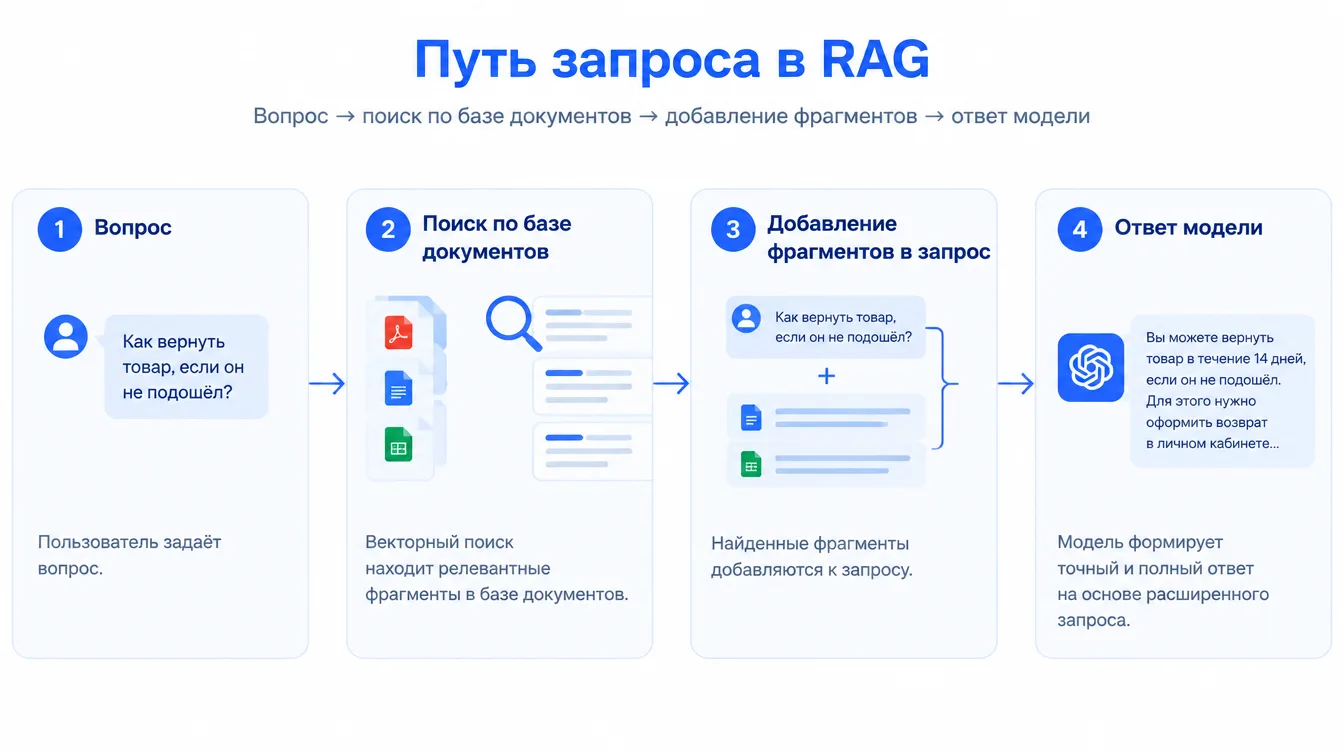
Важно: поиск идёт по смыслу, а не по точным словам. Поэтому запрос «сколько дней отпуска» найдёт абзац про «ежегодный оплачиваемый отдых».
Особенности RAG на русском
С русским языком чаще всего ломается не модель, а данные.
Типичные проблемы:
- англоязычные эмбеддинги плохо понимают падежи и синонимы;
- длинные предложения теряют смысл при грубой нарезке;
- в индексе копятся дубли и служебный шум;
- не хватает метаданных — названия раздела, даты, версии документа.
Как это исправляют:
- берут мультиязычные или обученные на русском эмбеддинги (например, семейства BGE и E5);
- режут тексты по смысловым границам — заголовкам и абзацам, а не по числу символов;
- добавляют к чанкам метаданные;
- проверяют поиск на реальных вопросах пользователей до подключения модели.
Совет: составьте контрольный список из 30–50 типичных вопросов с правильными источниками и прогоняйте его после каждого изменения настроек. Это самый дешёвый способ заметить деградацию.
Из чего собрать систему
1. Языковая модель (LLM)
Генерирует итоговый ответ по найденному контексту. Используют модели из облачных API или открытые модели на собственном сервере.
Ключевые преимущества облачных API:
- высокое качество без своего железа;
- быстрый старт.
Минусы:
- платная подписка или оплата за токены;
- данные уходят внешнему провайдеру;
- для российских пользователей нужен способ оплаты.
2. Векторная база
Хранит эмбеддинги и быстро ищет ближайшие. Распространены Qdrant, Weaviate, Chroma, FAISS и облачный Pinecone.
Ключевые преимущества:
- быстрый семантический поиск по большим объёмам;
- фильтры по метаданным.
Минусы:
- нужна настройка и сопровождение;
- облачные версии платные.
3. Эмбеддинг-модель
От неё зависит, насколько точно система «понимает» вопрос. Для русского начните с мультиязычных вариантов и сравните их на своём наборе вопросов.
Типы RAG: от простого к сложному
| Тип | Суть | Где применяют |
|---|---|---|
| Простой | Один индекс, одна модель | Прототипы и тесты |
| Векторный | Точный семантический поиск | Поиск по документам |
| Гибридный | Поиск по словам и по смыслу вместе | Коммерческие сервисы |
| Multi-source | Несколько источников данных | Аналитика, большие системы |
| Agent-based | Модель сама решает, где искать | Сложные ассистенты |
Для первых проектов хватает простого или векторного варианта. Гибридный поиск стоит добавить, когда в документах много артикулов, терминов и аббревиатур: чисто смысловой поиск их пропускает.
Как оплатить зарубежные API из России
Платные API нужны, когда проект выходит из стадии теста: больше нагрузки, строже требования к скорости и качеству. Многие провайдеры не принимают российские карты, поэтому пользователи выбирают:
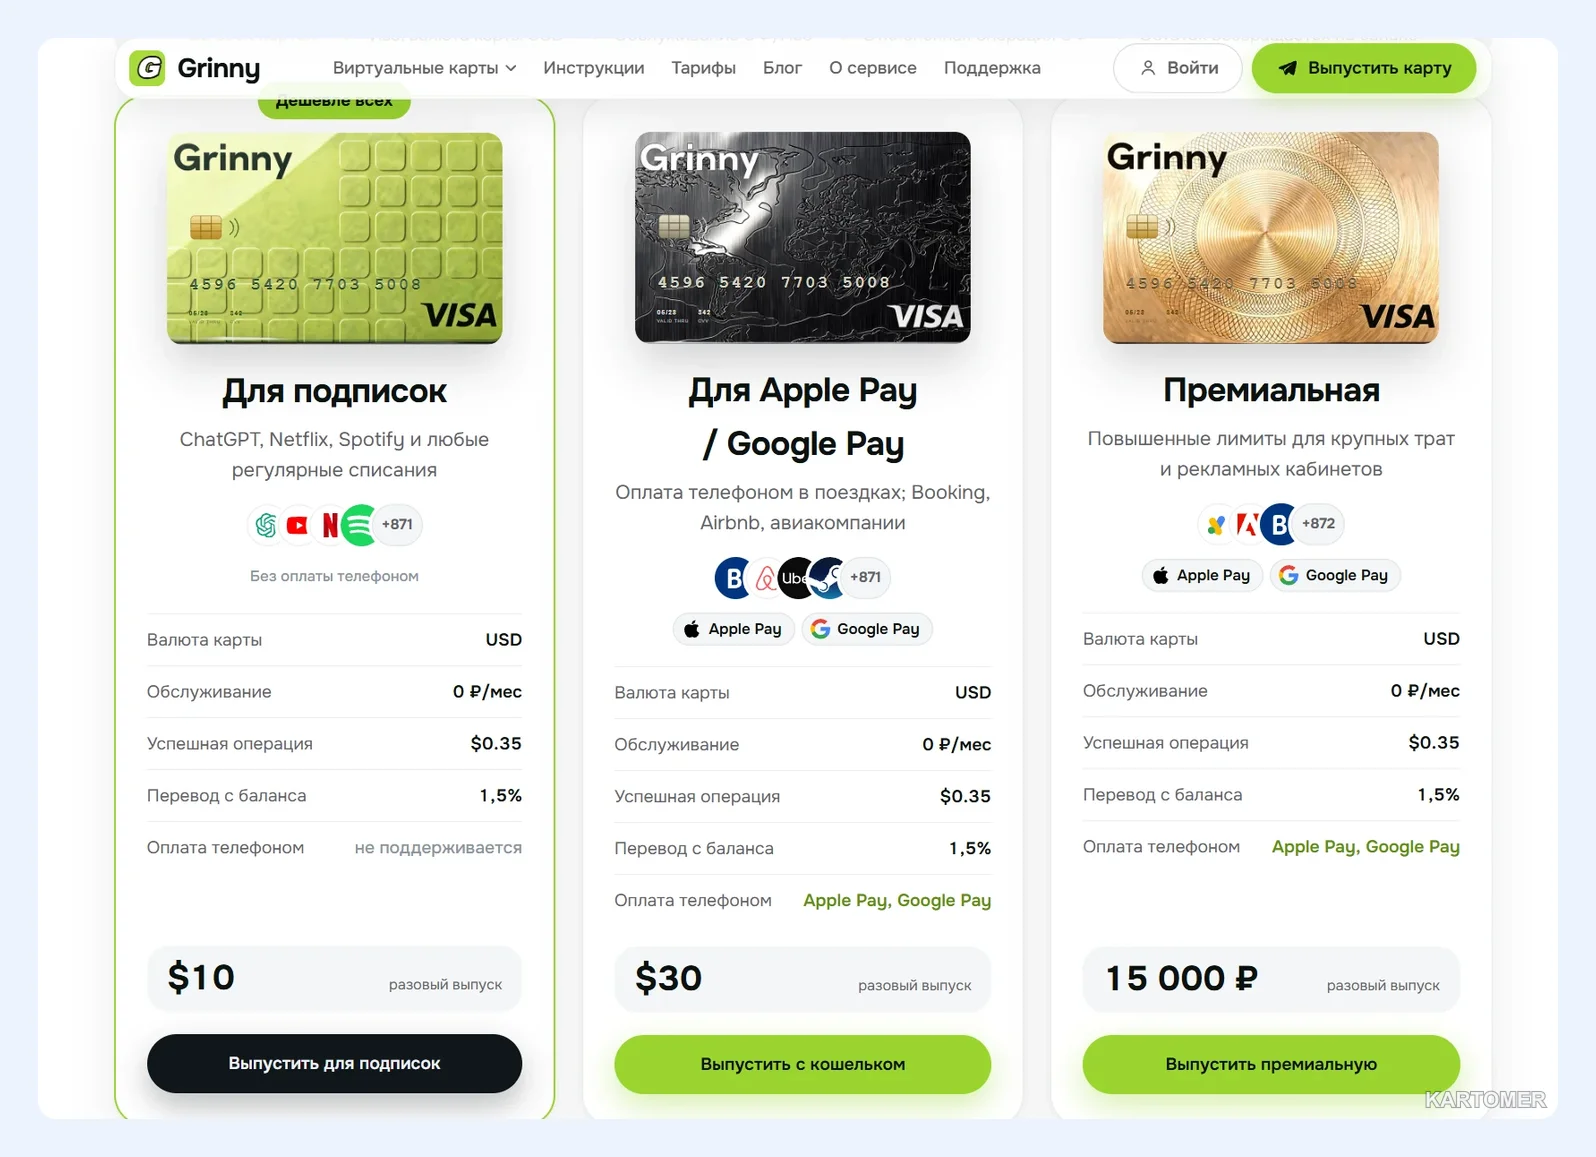
- виртуальную карту — самый прозрачный путь, платёж вы проводите сами;
- посредников по заявке — удобно для разовых пополнений, но важно проверять репутацию;
- частных продавцов — самый рискованный вариант.
Например, Grinny выпускает виртуальную карту в Telegram-боте с пополнением рублями через СБП. Другие варианты — в рейтинге виртуальных карт. Для популярных моделей есть отдельные инструкции, например по ChatGPT и Claude.
Итоги
✅ RAG заставляет модель отвечать по найденным фрагментам, а не по памяти.
✅ Качество определяется поиском: нарезкой, эмбеддингами и метаданными.
✅ Для русского нужны мультиязычные эмбеддинги и проверка на реальных вопросах.
✅ Начинайте с простой схемы и усложняйте по мере роста задач.
Какой вариант выбрать?
- Тест на небольшом наборе файлов → простой RAG.
- Поиск по базе знаний → векторный вариант.
- Много терминов и артикулов → гибридный поиск.
- Данные из разных систем → multi-source.
Частые вопросы
RAG полностью убирает галлюцинации?
Нет, он их снижает. Если поиск вернул нерелевантный текст, модель может ошибиться, поэтому показывайте пользователю источники.
Чем RAG отличается от дообучения модели?
RAG подключает знания при запросе, и базу легко обновлять. Дообучение меняет саму модель и дороже в поддержке.
Нужна ли отдельная векторная база?
Для прототипа достаточно FAISS или Chroma. Для продакшена обычно берут Qdrant, Weaviate или облачный сервис.
Как платить за API?
Виртуальной картой или через проверенного посредника. Начните с небольшой суммы.
Заключение
RAG — самый практичный способ подружить языковую модель с вашими документами. Он не требует дорогого обучения, а результат вы можете проверять по источникам. С русским языком главное внимание уделите подготовке данных и эмбеддингам, остальное решается тестами.
Соберите минимальную версию, проверьте её на реальных вопросах и улучшайте шаг за шагом. Так вы получите ассистента, которому можно доверять.